
Transformers documentation
PoolFormer
Ce modèle a été publié dans HF papers le 2021-11-22 et ajouté à Hugging Face Transformers le 2022-02-17.
PoolFormer
Aperçu
Le modèle PoolFormer a été proposé dans MetaFormer is Actually What You Need for Vision par Sea AI Labs. Plutôt que de concevoir des mélangeurs de jetons complexes pour atteindre des performances SOTA, l'objectif de ce travail est de démontrer que la compétence des modèles de transformer provient largement de l'architecture générale MetaFormer.
L'abstract de l'article est le suivant :
Les Transformers ont fait preuve d'un grand potentiel dans les tâches de vision par ordinateur. Il est généralement admis que leur module de mélange de jetons basé sur l'attention contribue le plus à leurs compétences. Cependant, des travaux récents montrent que le module basé sur l'attention des Transformers peut être remplacé par des MLP spatiaux, et que les modèles résultants obtiennent de bonnes performances. Sur la base de cette observation, nous émettons l'hypothèse que l'architecture générale des Transformers, plutôt que le module spécifique de mélange de jetons, est plus essentielle aux performances du modèle. Pour le vérifier, nous remplaçons délibérément le module d'attention des Transformers par un opérateur de pooling spatial étonnamment simple afin de n'effectuer que le mélange de jetons le plus basique. Étonnamment, nous observons que le modèle dérivé, appelé PoolFormer, atteint des performances compétitives sur plusieurs tâches de vision par ordinateur. Par exemple, sur ImageNet-1K, PoolFormer atteint une précision top-1 de 82,1 %, dépassant les baselines DeiT-B/ResMLP-B24, qui sont des Transformers/MLP de vision bien ajustés, de 0,3 %/1,1 % de précision avec 35 %/52 % de paramètres en moins et 48 %/60 % de MACs en moins. L'efficacité de PoolFormer confirme notre hypothèse et nous pousse à initier le concept de « MetaFormer », une architecture générale abstraite des Transformers sans spécifier le mélangeur de jetons. Sur la base d'expériences étendues, nous soutenons que le MetaFormer est le principal acteur dans l'obtention de résultats supérieurs pour les modèles récents de type Transformer et MLP sur les tâches de vision. Ce travail appelle à davantage de recherches futures dédiées à l'amélioration du MetaFormer plutôt qu'à se concentrer sur les modules de mélange de jetons. De plus, notre PoolFormer proposé peut servir de baseline de départ pour la conception future d'architectures MetaFormer.
La figure ci-dessous illustre l'architecture de PoolFormer. Tirée de l'article original.
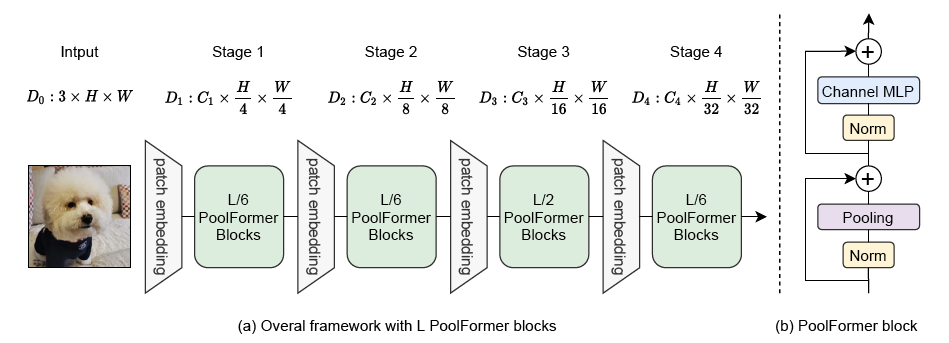
Ce modèle a été contribué par heytanay. Le code d'origine peut être trouvé ici.
Conseils d'utilisation
- PoolFormer possède une architecture hiérarchique, où une simple couche de Average Pooling est présente à la place de l'Attention. Tous les points de contrôle du modèle sont disponibles sur le hub.
- On peut utiliser PoolFormerImageProcessor pour préparer les images destinées au modèle.
- Comme la plupart des modèles, PoolFormer est disponible en différentes tailles, dont les détails figurent dans le tableau ci-dessous.
| Variante de modèle | Profondeurs | Tailles cachées | Paramètres (M) | ImageNet-1k Top 1 |
|---|---|---|---|---|
| s12 | [2, 2, 6, 2] | [64, 128, 320, 512] | 12 | 77.2 |
| s24 | [4, 4, 12, 4] | [64, 128, 320, 512] | 21 | 80.3 |
| s36 | [6, 6, 18, 6] | [64, 128, 320, 512] | 31 | 81.4 |
| m36 | [6, 6, 18, 6] | [96, 192, 384, 768] | 56 | 82.1 |
| m48 | [8, 8, 24, 8] | [96, 192, 384, 768] | 73 | 82.5 |
Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec PoolFormer.
- PoolFormerForImageClassification est pris en charge par ce notebook.
- Voir aussi : Guide de la tâche de classification d'images
Si vous souhaitez soumettre une ressource pour qu'elle soit incluse ici, n'hésitez pas à ouvrir une Pull Request et nous la examinerons ! La ressource devrait idéalement démontrer quelque chose de nouveau plutôt que de dupliquer une ressource existante.
PoolFormerConfig
classe transformers.PoolFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3patch_size: int | list[int] | tuple[int, int] = 16stride: int = 16pool_size: int = 3mlp_ratio: float = 4.0depths: list[int] | tuple[int, ...] = (2, 2, 6, 2)hidden_sizes: list[int] | tuple[int, ...] = (64, 128, 320, 512)patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3)strides: list[int] | tuple[int, ...] = (4, 2, 2, 2)padding: list[int] | tuple[int, ...] = (2, 1, 1, 1)num_encoder_blocks: int = 4drop_path_rate: float | int = 0.0hidden_act: str = 'gelu'use_layer_scale: bool = Truelayer_scale_init_value: float = 1e-05initializer_range: float = 0.02 )
Paramètres
- num_channels (
int, facultatif, par défaut3) — Le nombre de canaux d'entrée. - patch_size (
Union[int, list[int], tuple[int, int]], facultatif, par défaut16) — La taille (résolution) de chaque patch. - stride (
int, facultatif, par défaut 16) — Le pas du patch d'entrée. - pool_size (
int, facultatif, valeur par défaut 3) — La taille de la fenêtre de pooling. - mlp_ratio (
float, facultatif, par défaut4.0) — Ratio de la dimension cachée du MLP par rapport à la dimension d'embedding. - depths (
Union[list[int], tuple[int, ...]], facultatif, par défaut(2, 2, 6, 2)) — Profondeur de chaque couche du Transformer. - hidden_sizes (
Union[list[int], tuple[int, ...]], facultatif, par défaut(64, 128, 320, 512)) — Dimension (taille cachée) à chaque étape du modèle. - patch_sizes (
list, facultatif, par défaut[7, 3, 3, 3]) — La taille du patch d'entrée pour chaque bloc d'encodeur. - strides (
list, facultatif, par défaut[4, 2, 2, 2]) — Le pas du patch d'entrée pour chaque bloc d'encodeur. - padding (
list, facultatif, par défaut[2, 1, 1, 1]) — Le padding du patch d'entrée pour chaque bloc encodeur. - num_encoder_blocks (
int, facultatif, valeur par défaut 4) — Le nombre de blocs encodeur. - drop_path_rate (
Union[float, int], facultatif, par défaut0.0) — Taux de drop path pour la fusion des patches. - hidden_act (
str, facultatif, par défautgelu) — La fonction d'activation non linéaire (fonction ou chaîne de caractères) du décodeur. Par exemple,"gelu","relu","silu", etc. - use_layer_scale (
bool, facultatif, par défautTrue) — Indique s'il faut utiliser le layer scale. - layer_scale_init_value (
float, facultatif, par défaut1e-05) — Échelle à utiliser dans les couches d'auto-attention. 0.1 pour les modèles de base, 1e-6 pour les grands modèles. Définir 0 pour désactiver l'échelle de couche. - initializer_range (
float, facultatif, par défaut0.02) — L'écart-type de la truncated_normal_initializer utilisé pour initialiser toutes les matrices de poids.
Ceci est la classe de configuration destinée à stocker la configuration d'un PoolFormerModel. Elle est utilisée pour instancier un modèle Poolformer en fonction des arguments spécifiés, définissant ainsi l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de sail/poolformer_s12
Les objets de configuration héritent de PreTrainedConfig et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de PreTrainedConfig pour plus d’informations.
Exemple :
>>> from transformers import PoolFormerConfig, PoolFormerModel

>>> # Initializing a PoolFormer sail/poolformer_s12 style configuration
>>> configuration = PoolFormerConfig()

>>> # Initializing a model (with random weights) from the sail/poolformer_s12 style configuration
>>> model = PoolFormerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
PoolFormerImageProcessor
classe transformers.PoolFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_poolformer.PoolFormerImageProcessorKwargs'> )
Paramètres
- do_convert_rgb (
bool, kwargs, facultatif, valeur par défautNone) — Indique s'il faut convertir l'image en RGB. - do_resize (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut redimensionner l'image. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, par défaut{'shortest_edge' -- 224}) : Définit les dimensions maximales de l'entrée du modèle. - default_to_square (
bool, kwargs, facultatif, valeur par défautFalse) — Indique s'il faut utiliser une image carrée par défaut lors du redimensionnement, si size est un entier. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, par défaut{'height' -- 224, 'width': 224}) : Taille de l'image de sortie après application decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, par défaut3) — Filtre de rééchantillonnage à utiliser lors du redimensionnement de l’image. Il peut s’agir de l’une des valeurs de l’enumPILImageResampling. N’a un effet que sido_resizeest défini surTrue. - do_rescale (
bool, kwargs, facultatif, par défautTrue) — Indique s'il faut rééchelonner l'image. - rescale_factor (
float, kwargs, facultatif, valeur par défaut0.00392156862745098) — Facteur de remise à l'échelle appliqué à l'image sido_rescaleest défini surTrue. - do_normalize (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut normaliser l'image. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif, valeur par défaut[0.485, 0.456, 0.406]) — Moyenne de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif, valeur par défaut[0.229, 0.224, 0.225]) — Écart-type de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - do_pad (
bool, kwargs, facultatif) — Indique s'il faut effectuer un bourrage (padding) de l'image. Le bourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de bourrage exacte dépend du modèle. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — La taille au format{"height": int, "width" int}à laquelle les images doivent être remplies. Elle doit être supérieure à la taille de n'importe quelle image fournie pour la prétraitement. Sipad_sizen'est pas fourni, les images seront remplies jusqu'à la hauteur et la largeur maximales du lot. Appliqué uniquement lorsquedo_pad=True. - do_center_crop (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut effectuer un recadrage centré de l'image. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — SeulChannelDimension.FIRSTest pris en charge. Ajouté pour la compatibilité avec les processeurs lents. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants :"channels_first"ouChannelDimension.FIRST: image au format (num_channels, height, width)."channels_last"ouChannelDimension.LAST: image au format (hauteur, largeur, nombre de canaux)."none"ouChannelDimension.NONE: image au format (hauteur, largeur).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — L’appareil sur lequel traiter les vidéos. Si non défini, l’appareil est déduit des vidéos d’entrée. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retourne des tenseurs empilés si défini sur'pt', sinon retourne une liste de tenseurs. - disable_grouping (
bool, kwargs, facultatif) — Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle est définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, facultatif) — Le nombre de jetons d’image à utiliser pour chaque image de l’entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles. - crop_pct (
float, kwargs, facultatif, valeur par défautself.crop_pct) — Pourcentage de l'image à recadrer. N'a un effet que sido_resizeest défini surTrue.
Construit un processeur d’images PoolFormerImageProcessor.
prétraiter
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Paramètres
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Image à prétraiter. S'attend à une image unique ou à un lot d'images dont les valeurs de pixels vont de 0 à 255. Si vous passez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissezdo_rescale=False. - image_like_kwargs (
dict[str, Any], facultatif) — Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant que mot-clé ne fonctionne pas. Par exemple,preprocess(images, masks=masks)est l'option recommandée, mais elle peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas,preprocess(images, image_like_inputs={"masks": masks})peut être utilisé à la place. - do_convert_rgb (
bool, kwargs, facultatif) — Indique s'il faut convertir l'image en RGB. - do_resize (
bool, kwargs, facultatif) — Indique s'il faut redimensionner l'image. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Définit les dimensions maximales des entrées du modèle. - default_to_square (
bool, kwargs, facultatif) — Indique s'il faut par défaut redimensionner l'image en carré si la taille est un entier. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Taille de l'image de sortie après application decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtre de rééchantillonnage à utiliser lors du redimensionnement de l’image. Il peut s’agir de l’une des valeurs de l’enumPILImageResampling. N’a un effet que sido_resizeest défini surTrue. - do_rescale (
bool, kwargs, facultatif) — Indique s'il faut rééchelonner l'image. - rescale_factor (
float, kwargs, facultatif) — Facteur de remise à l'échelle à appliquer à l'image sido_rescaleest défini surTrue. - do_normalize (
bool, kwargs, facultatif) — Indique s'il faut normaliser l'image. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif) — Moyenne de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif) — Écart-type de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - do_pad (
bool, kwargs, facultatif) — Indique s'il faut effectuer un bourrage (padding) de l'image. Le bourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de bourrage exacte dépend du modèle. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — La taille au format{"height": int, "width" int}à laquelle les images doivent être remplies. Elle doit être supérieure à la taille de n'importe quelle image fournie pour la prétraitement. Sipad_sizen'est pas fourni, les images seront remplies jusqu'à la hauteur et la largeur maximales du lot. Appliqué uniquement lorsquedo_pad=True. - do_center_crop (
bool, kwargs, facultatif) — Indique s'il faut effectuer un recadrage centré de l'image. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — SeulChannelDimension.FIRSTest pris en charge. Ajouté pour la compatibilité avec les processeurs lents. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants :"channels_first"ouChannelDimension.FIRST: image au format (num_channels, height, width)."channels_last"ouChannelDimension.LAST: image au format (hauteur, largeur, nombre de canaux)."none"ouChannelDimension.NONE: image au format (hauteur, largeur).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — L’appareil sur lequel traiter les vidéos. Si non défini, l’appareil est déduit des vidéos d’entrée. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retourne des tenseurs empilés si défini sur'pt', sinon retourne une liste de tenseurs. - disable_grouping (
bool, kwargs, facultatif) — Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle est définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, facultatif) — Le nombre de jetons d’image à utiliser pour chaque image de l’entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
Retourne
~image_processing_base.BatchFeature
- data (
dict) — Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode call (« pixel_values », etc.). - tensor_type (
Union[None, str, TensorType], facultatif) — Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
PoolFormerImageProcessorPil
classe transformers.PoolFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_pil_poolformer.PoolFormerImageProcessorKwargs'> )
Paramètres
- do_convert_rgb (
bool, kwargs, facultatif, valeur par défautNone) — Indique s'il faut convertir l'image en RGB. - do_resize (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut redimensionner l'image. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, par défaut{'shortest_edge' -- 224}) : Définit les dimensions maximales de l'entrée du modèle. - default_to_square (
bool, kwargs, facultatif, valeur par défautFalse) — Indique s'il faut utiliser une image carrée par défaut lors du redimensionnement, si size est un entier. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, par défaut{'height' -- 224, 'width': 224}) : Taille de l'image de sortie après application decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, par défaut3) — Filtre de rééchantillonnage à utiliser lors du redimensionnement de l’image. Il peut s’agir de l’une des valeurs de l’enumPILImageResampling. N’a un effet que sido_resizeest défini surTrue. - do_rescale (
bool, kwargs, facultatif, par défautTrue) — Indique s'il faut rééchelonner l'image. - rescale_factor (
float, kwargs, facultatif, valeur par défaut0.00392156862745098) — Facteur de remise à l'échelle appliqué à l'image sido_rescaleest défini surTrue. - do_normalize (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut normaliser l'image. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif, valeur par défaut[0.485, 0.456, 0.406]) — Moyenne de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif, valeur par défaut[0.229, 0.224, 0.225]) — Écart-type de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - do_pad (
bool, kwargs, facultatif) — Indique s'il faut effectuer un bourrage (padding) de l'image. Le bourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de bourrage exacte dépend du modèle. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — La taille au format{"height": int, "width" int}à laquelle les images doivent être remplies. Elle doit être supérieure à la taille de n'importe quelle image fournie pour la prétraitement. Sipad_sizen'est pas fourni, les images seront remplies jusqu'à la hauteur et la largeur maximales du lot. Appliqué uniquement lorsquedo_pad=True. - do_center_crop (
bool, kwargs, facultatif, valeur par défautTrue) — Indique s'il faut effectuer un recadrage centré de l'image. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — SeulChannelDimension.FIRSTest pris en charge. Ajouté pour la compatibilité avec les processeurs lents. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants :"channels_first"ouChannelDimension.FIRST: image au format (num_channels, height, width)."channels_last"ouChannelDimension.LAST: image au format (hauteur, largeur, nombre de canaux)."none"ouChannelDimension.NONE: image au format (hauteur, largeur).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — L’appareil sur lequel traiter les vidéos. Si non défini, l’appareil est déduit des vidéos d’entrée. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retourne des tenseurs empilés si défini sur'pt', sinon retourne une liste de tenseurs. - disable_grouping (
bool, kwargs, facultatif) — Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle est définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, facultatif) — Le nombre de jetons d’image à utiliser pour chaque image de l’entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles. - crop_pct (
float, kwargs, facultatif, valeur par défautself.crop_pct) — Pourcentage de l'image à recadrer. N'a un effet que sido_resizeest défini surTrue.
Construit un processeur d’images PoolFormerImageProcessor.
prétraiter
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Paramètres
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Image à prétraiter. S'attend à une image unique ou à un lot d'images dont les valeurs de pixels vont de 0 à 255. Si vous passez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissezdo_rescale=False. - image_like_kwargs (
dict[str, Any], facultatif) — Drapeau de développement pour des entrées supplémentaires de type image qui seront également prétraitées. N'utilisez ce paramètre que si le passage des entrées en tant que mot-clé ne fonctionne pas. Par exemple,preprocess(images, masks=masks)est l'option recommandée, mais elle peut entraîner des problèmes de priorité des arguments pour certains modèles. Dans ces cas,preprocess(images, image_like_inputs={"masks": masks})peut être utilisé à la place. - do_convert_rgb (
bool, kwargs, facultatif) — Indique s'il faut convertir l'image en RGB. - do_resize (
bool, kwargs, facultatif) — Indique s'il faut redimensionner l'image. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Définit les dimensions maximales des entrées du modèle. - default_to_square (
bool, kwargs, facultatif) — Indique s'il faut par défaut redimensionner l'image en carré si la taille est un entier. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Taille de l'image de sortie après application decenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Filtre de rééchantillonnage à utiliser lors du redimensionnement de l’image. Il peut s’agir de l’une des valeurs de l’enumPILImageResampling. N’a un effet que sido_resizeest défini surTrue. - do_rescale (
bool, kwargs, facultatif) — Indique s'il faut rééchelonner l'image. - rescale_factor (
float, kwargs, facultatif) — Facteur de remise à l'échelle à appliquer à l'image sido_rescaleest défini surTrue. - do_normalize (
bool, kwargs, facultatif) — Indique s'il faut normaliser l'image. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif) — Moyenne de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, facultatif) — Écart-type de l'image à utiliser pour la normalisation. N'a un effet que sido_normalizeest défini surTrue. - do_pad (
bool, kwargs, facultatif) — Indique s'il faut effectuer un bourrage (padding) de l'image. Le bourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de bourrage exacte dépend du modèle. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — La taille au format{"height": int, "width" int}à laquelle les images doivent être remplies. Elle doit être supérieure à la taille de n'importe quelle image fournie pour la prétraitement. Sipad_sizen'est pas fourni, les images seront remplies jusqu'à la hauteur et la largeur maximales du lot. Appliqué uniquement lorsquedo_pad=True. - do_center_crop (
bool, kwargs, facultatif) — Indique s'il faut effectuer un recadrage centré de l'image. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — SeulChannelDimension.FIRSTest pris en charge. Ajouté pour la compatibilité avec les processeurs lents. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, facultatif) — Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants :"channels_first"ouChannelDimension.FIRST: image au format (num_channels, height, width)."channels_last"ouChannelDimension.LAST: image au format (hauteur, largeur, nombre de canaux)."none"ouChannelDimension.NONE: image au format (hauteur, largeur).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — L’appareil sur lequel traiter les vidéos. Si non défini, l’appareil est déduit des vidéos d’entrée. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Retourne des tenseurs empilés si défini sur'pt', sinon retourne une liste de tenseurs. - disable_grouping (
bool, kwargs, facultatif) — Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle est définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, facultatif) — Le nombre de jetons d’image à utiliser pour chaque image de l’entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
Retourne
~image_processing_base.BatchFeature
- data (
dict) — Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode call (« pixel_values », etc.). - tensor_type (
Union[None, str, TensorType], facultatif) — Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
Prétraitez une image ou un lot d'images.
PoolFormerModel
classe transformers.PoolFormerModel
< source >( config: PoolFormerConfig )
Paramètres
- config (PoolFormerConfig) — Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode from_pretrained() pour charger les poids du modèle.
Le modèle Poolformer brut, qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de PreTrainedModel. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, la taille des têtes, etc.)
Ce modèle est également une sous-classe de torch.nn.Module de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l'utilisation et le comportement généraux.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithNoAttention or tuple(torch.Tensor)
Paramètres
- pixel_values (
torch.Tensorde forme(batch_size, num_channels, image_size, image_size), facultatif) — Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de PoolFormerImageProcessor. Voir PoolFormerImageProcessor.call() pour plus de détails (processor_classutilise PoolFormerImageProcessor pour le traitement des images). - output_hidden_states (
bool, facultatif) — Indique s'il faut retourner les états cachés de toutes les couches. Voirhidden_statessous les tenseurs retournés pour plus de détails. - return_dict (
bool, facultatif) — Indique s'il faut retourner un ModelOutput plutôt qu'un simple tuple.
Retourne
BaseModelOutputWithNoAttention ou tuple(torch.Tensor)
Un BaseModelOutputWithNoAttention ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (PoolFormerConfig) et des entrées.
La méthode forward du modèle PoolFormerModel surcharge la méthode spéciale __call__.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance
Moduleplutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
last_hidden_state (
torch.Tensorde forme(batch_size, num_channels, height, width)) — Séquence d'états cachés à la sortie de la dernière couche du modèle.hidden_states (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme(batch_size, num_channels, height, width).États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
PoolFormerForImageClassification
classe transformers.PoolFormerForImageClassification
< source >( config: PoolFormerConfig )
Paramètres
- config (PoolFormerConfig) — Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode from_pretrained() pour charger les poids du modèle.
PoolFormer Transformeur de modèle avec une tête de classification d'images
Ce modèle hérite de PreTrainedModel. Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, la taille des têtes, etc.)
Ce modèle est également une sous-classe de torch.nn.Module de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l'utilisation et le comportement généraux.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → ImageClassifierOutputWithNoAttention or tuple(torch.Tensor)
Paramètres
- pixel_values (
torch.Tensorde forme(batch_size, num_channels, image_size, image_size), facultatif) — Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de PoolFormerImageProcessor. Voir PoolFormerImageProcessor.call() pour plus de détails (processor_classutilise PoolFormerImageProcessor pour le traitement des images). - labels (
torch.LongTensorde forme(batch_size,), facultatif) — Étiquettes pour le calcul de la perte de classification/régression d'image. Les indices doivent être dans[0, ..., config.num_labels - 1]. Siconfig.num_labels == 1, une perte de régression est calculée (perte du carré moyen). Siconfig.num_labels > 1, une perte de classification est calculée (entropie croisée). - output_hidden_states (
bool, facultatif) — Indique s'il faut retourner les états cachés de toutes les couches. Voirhidden_statessous les tenseurs retournés pour plus de détails. - return_dict (
bool, facultatif) — Indique s'il faut retourner un ModelOutput plutôt qu'un simple tuple.
Retourne
ImageClassifierOutputWithNoAttention ou tuple(torch.Tensor)
Un ImageClassifierOutputWithNoAttention ou un tuple de
torch.Tensor (si return_dict=False est passé ou lorsque config.return_dict=False) comprenant divers
éléments en fonction de la configuration (PoolFormerConfig) et des entrées.
La méthode forward de PoolFormerForImageClassification redéfinit la méthode spéciale __call__.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance
Moduleplutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- loss (
torch.Tensorde forme(1,), facultatif, renvoyé lorsquelabelsest fourni) — Perte de classification (ou de régression si config.num_labels==1). - logits (
torch.Tensorde forme(batch_size, config.num_labels)) — Scores de classification (ou de régression si config.num_labels==1) (avant SoftMax). - hidden_states (
tuple(torch.Tensor), facultatif, renvoyé lorsqueoutput_hidden_states=Trueest passé ou lorsqueconfig.output_hidden_states=True) — Tuple detorch.Tensor(un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque étape) de forme(batch_size, num_channels, height, width). États cachés (aussi appelés cartes de caractéristiques) du modèle à la sortie de chaque étape.
Exemple :
>>> from transformers import AutoImageProcessor, PoolFormerForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("sail/poolformer_s12")
>>> model = PoolFormerForImageClassification.from_pretrained("sail/poolformer_s12")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...